La calidad del dato también es parte de la integración
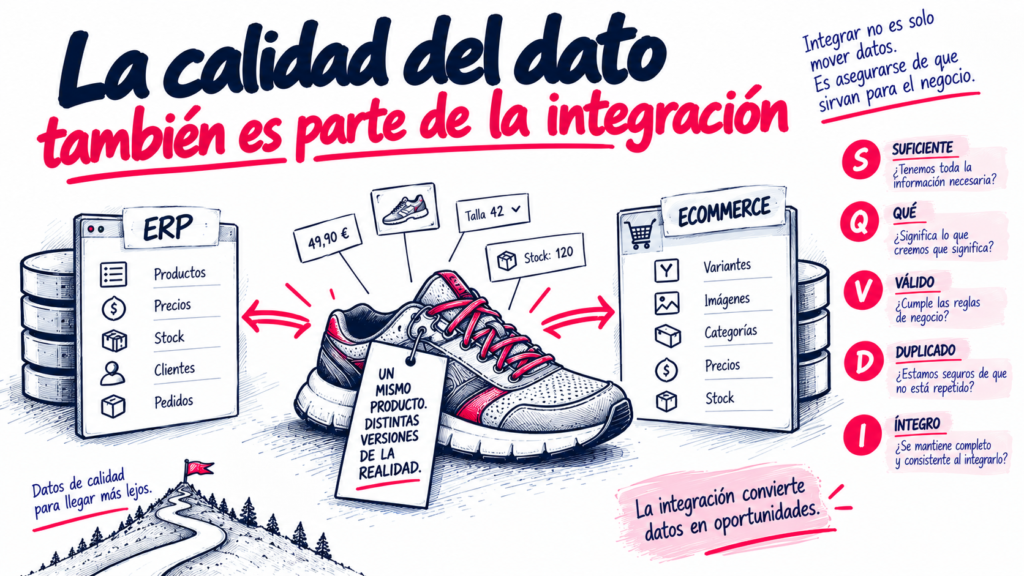
5 controles de calidad de datos en una integración
Un dato puede ser correcto en el ERP, válido en el ecommerce y, aun así, provocar un error cuando intentamos sincronizarlos. Cada sistema interpreta la información según sus propias reglas, estructuras y objetivos. Por eso, integrar no consiste únicamente en trasladar valores de un lugar a otro: también implica comprobar que esos valores representan lo mismo, que están completos para la operación que queremos realizar y que conservan sus relaciones con el resto de la información.
Cuando una integración falla, el origen del problema no siempre está en una conexión interrumpida o en un error técnico. A veces, el proceso funciona exactamente como se ha diseñado, pero transmite un precio con otro significado, asigna una existencia al producto equivocado o crea un registro duplicado porque no puede reconocer que ya existía. La automatización puede mover los datos con rapidez, pero no garantiza por sí sola que sean adecuados para el sistema de destino.
Por eso, la calidad del dato también forma parte de la integración. Antes de sincronizar información entre aplicaciones, necesitamos entender qué representa, qué reglas debe cumplir, qué sistema tiene autoridad sobre ella y qué puede ocurrir cuando cambia durante el proceso.
Imagina que una empresa vende zapatillas deportivas a través de su ecommerce y gestiona su actividad con un ERP.
En el ERP, un artículo tiene una referencia, una descripción, un precio y unas existencias. En el ecommerce, ese mismo artículo tiene varias tallas, imágenes, categorías y un precio que puede depender del cliente. Un proveedor facilita información adicional y un sistema de gestión de activos digitales mantiene las fotografías.
Cada sistema contiene información válida para su propia función. Ninguno tiene necesariamente toda la información que necesitan los demás.
Ahora queremos integrarlos.
¿Podemos asumir que, porque los datos existen y cada aplicación funciona correctamente, la integración también funcionará?
No necesariamente.
Una integración puede transmitir perfectamente un dato incorrecto, incompleto, desactualizado o mal interpretado. Y cuanto más automatizado esté el proceso, más rápidamente puede propagarse el problema.
La calidad del dato no termina en cada aplicación. También importa lo que ocurre entre ellas.
No es lo mismo preparar datos para analizarlos que para operar con ellos
Cuando hablamos de calidad del dato, encontramos habitualmente seis dimensiones: exactitud, completitud, consistencia, unicidad, validez y actualidad.
Son criterios ampliamente utilizados en gestión de datos y resultan útiles en prácticamente cualquier escenario. Sin embargo, muchos de los ejemplos y herramientas que encontramos alrededor de estas dimensiones se centran en procesos ETL, plataformas analíticas y almacenes de datos.
En esos entornos, el objetivo suele ser consolidar información procedente de distintas fuentes para obtener informes fiables, calcular indicadores o alimentar modelos de análisis.
Como explica IBM en su guía sobre las dimensiones de la calidad de los datos, la exactitud, completitud, consistencia, unicidad, validez y actualidad permiten evaluar la fiabilidad de la información. Pero ¿qué ocurre cuando esos datos deben pasar continuamente de un sistema operativo a otro?
Por ejemplo, si un cliente aparece duplicado en tres bases de datos, podemos identificar los registros, aplicar reglas de consolidación y construir una representación unificada para analizar sus compras.
En una integración operativa, la situación es diferente.
El ERP y el ecommerce no son simples fuentes que descargamos periódicamente en un repositorio. Son dos sistemas vivos, con sus propios modelos de datos, reglas de negocio y procesos de actualización.
Mientras sincronizamos un producto, alguien puede modificar su precio. Mientras incorporamos un pedido al ERP, el ecommerce puede recibir otro. Mientras actualizamos existencias, una venta puede consumir parte del Stock disponible.
Además, los sistemas no siempre representan los mismos conceptos de la misma manera.
Un producto en el ERP puede corresponder a varias variantes en el ecommerce. Una cuenta comercial puede relacionarse con diferentes compradores. Una dirección de entrega no tiene por qué ser la dirección de facturación. Y una tarifa válida en el ERP puede necesitar una transformación antes de utilizarse en la tienda.
La calidad del dato sigue siendo importante, pero ahora debemos evaluarla en relación con una operación concreta.
No basta con preguntarse si el dato es correcto.
Tenemos que preguntarnos si es el dato adecuado, si significa lo mismo, si cumple las reglas del destino y si mantiene sus relaciones durante la integración.
4 fuentes, un producto y varias versiones de la realidad
Supongamos que queremos publicar un producto en nuestro ecommerce.
Tenemos información distribuida entre cuatro sistemas:
| Sistema | Información disponible |
| ERP | Referencia ART-001, descripción, precio de 49,90 € y 120 unidades |
| Ecommerce | Producto Running Shoes, precio de 39,95 €, variantes y una imagen |
| Proveedor | Descripción adicional, precio recomendado y disponibilidad |
| Gestor de imágenes | Tres fotografías, una de ellas destacada |
¿Son incorrectos estos datos?
No necesariamente.
El precio del ERP puede ser la tarifa general, mientras que el ecommerce utiliza una promoción. Las existencias del proveedor pueden representar disponibilidad externa y no stock propio. La referencia del ERP puede identificar un modelo, mientras que las variantes de la tienda identifican combinaciones de talla y color.
El problema no es que tengamos diferentes valores.
El problema aparece cuando no sabemos qué significa cada valor, qué relación mantiene con los demás o qué regla determina cuál debemos utilizar.
Una integración que copie indiscriminadamente la información del ERP podría eliminar una promoción válida. Una que utilice el stock del proveedor como si fuera propio podría prometer unidades que no están disponibles para entrega inmediata.
La calidad del dato, en este contexto, requiere comprender tanto la información como las decisiones de negocio que determinan su utilización.
5 preguntas antes de integrar un dato
Podemos organizar estos controles mediante cinco preguntas prácticas.
No se trata de sustituir las dimensiones tradicionales de calidad del dato ni de crear una nueva norma. Se trata de trasladar sus principios al trabajo cotidiano de una integración ERP–ecommerce.
S — Suficiente: ¿tenemos toda la información necesaria?
Un registro puede ser perfectamente válido en el sistema de origen y estar incompleto para el sistema de destino.
Por ejemplo, nuestro ERP permite crear un artículo con referencia, descripción y precio. Sin embargo, para publicarlo en el ecommerce necesitamos conocer también su categoría, las variantes disponibles y, posiblemente, determinadas imágenes o atributos.
El producto está completo para el ERP, pero no necesariamente para la tienda.
La suficiencia depende de lo que queremos hacer con el dato.
Para actualizar existencias, quizá baste con una referencia y una cantidad. Para crear un producto nuevo, necesitaremos mucha más información. Para publicar un artículo B2B, también podríamos necesitar información sobre sus condiciones comerciales.
Por eso, los controles de suficiencia deben establecerse en función de cada operación.
No necesitamos comprobar todos los campos de un producto para actualizar su stock. Pero sí necesitamos garantizar que disponemos de la referencia correcta, que podemos identificar el almacén correspondiente y que la cantidad representa aquello que queremos sincronizar.
Un dato no es suficiente porque tenga todos sus campos informados. Es suficiente cuando contiene lo necesario para el uso que vamos a darle.
Q — Qué: ¿significa realmente lo que creemos que significa?
Esta es una de las preguntas más importantes y, posiblemente, una de las menos visibles en las herramientas tradicionales de integración.
Dos sistemas pueden utilizar el mismo nombre para representar conceptos diferentes.
Pensemos en un campo llamado Precio.
En el ERP puede representar el precio de venta sin impuestos. En el ecommerce puede representar el precio final con impuestos incluidos. En un Catálogo B2B puede depender de la tarifa asignada al cliente.
Los tres valores son Precios, pero no son intercambiables.
Lo mismo sucede con las cantidades.
¿El stock representa existencias físicas, disponibilidad para la venta o unidades disponibles después de descontar reservas?
Y con los identificadores.
¿La referencia identifica un producto, una variante, una combinación comercial o un código interno del proveedor?
Comprobar que es un número no resuelve el problema.
Aquí entran en juego la interpretación semántica, las correspondencias entre entidades, las unidades, los catálogos de valores y las convenciones de cada sistema.
La calidad semántica consiste en preservar el significado de la información, no simplemente su representación.
Y es especialmente importante cuando conectamos aplicaciones desarrolladas por fabricantes diferentes, que no comparten un modelo de datos común.
V — Válido: ¿cumple las reglas del negocio?
Una vez que sabemos qué representa un dato, debemos comprobar si puede utilizarse en la operación que queremos ejecutar.
Podemos tener un producto correcto y, aun así, no admitirlo porque su estado está marcado como inactivo.
Podemos recibir una talla que existe en el catálogo, pero que no corresponde al producto.
O podemos recibir un pedido con un producto válido en el ecommerce que no tiene una correspondencia configurada en el ERP.
En todos estos casos, el dato existe y podemos interpretarlo. Sin embargo, no cumple alguna condición necesaria para procesarlo.
Las validaciones pueden abarcar varios niveles:
- Estructurales: tipos de datos, longitudes, formatos y campos obligatorios.
- Referenciales: existencia de productos, Clientes, almacenes, tarifas y otras entidades relacionadas.
- De negocio: límites de precio, estados permitidos, restricciones comerciales y políticas específicas.
- Contextuales: condiciones que dependen de la operación, del cliente, del canal o de la configuración de la empresa.
No todas las anomalías deberían producir el mismo resultado.
Un pedido sin cliente identificable quizá deba bloquearse. Una descripción demasiado larga puede admitir una transformación. Una categoría desconocida puede requerir una correspondencia previamente definida.
La integración necesita distinguir entre lo que puede corregir mediante reglas conocidas y lo que requiere intervención.
Validar no es rechazar todos los datos imperfectos. Es decidir, de manera controlada, cuáles pueden continuar y bajo qué condiciones.
D — Duplicado: ¿estamos seguros de que no estamos creando otra versión del mismo dato?
La duplicidad es uno de los problemas clásicos de calidad de datos, pero en una integración operativa tiene una consecuencia especialmente importante: puede modificar el funcionamiento del negocio.
Si duplicamos un cliente, fragmentamos su historial comercial.
Si duplicamos un producto, podemos distribuir sus existencias y Pedidos entre referencias diferentes.
Si duplicamos un pedido, podríamos generar dos documentos comerciales para una única compra.
Y no siempre hablamos de registros exactamente iguales.
Un mismo fabricante puede aparecer como DistillRun, DISTILLRUN y Distill Run.
Dos sistemas pueden utilizar identificadores distintos para representar el mismo producto.
Un ecommerce puede enviar nuevamente un pedido porque no recibió confirmación de que la primera operación terminó correctamente.
Por tanto, debemos diferenciar dos problemas.
El primero es la identidad de las entidades: determinar cuándo dos registros representan realmente el mismo producto, cliente o variante.
El segundo es la idempotencia de las operaciones: garantizar que repetir una operación, por ejemplo debido a un reintento, no provoque una segunda creación no deseada.
Para resolverlos podemos utilizar identificadores externos, claves de correspondencia, reglas de consolidación y controles de operaciones ya procesadas.
Pero debemos tener cuidado con una simplificación habitual: dos registros parecidos no son necesariamente duplicados.
Dos direcciones de clientes pueden compartir razón social y pertenecer a cuentas comerciales diferentes. Dos variantes pueden compartir nombre y diferenciarse por un atributo que todavía no hemos consultado.
Eliminar duplicados no consiste en borrar lo que se parece, sino en identificar correctamente qué representa cada registro.
I — Íntegro: ¿conservamos las relaciones y la coherencia al integrarlo?
Una integración puede transmitir todos los campos correctamente y seguir produciendo un resultado incorrecto.
Imaginemos un producto con tres variantes, cada una con su propio SKU, precio y disponibilidad.
Podemos transferir todos los productos y todos los precios, pero relacionar una tarifa con la variante equivocada.
No hemos perdido registros. No tenemos valores fuera de rango. Tampoco hemos creado duplicados.
Sin embargo, la integración ha fallado.
La integridad exige conservar las relaciones entre entidades y garantizar que las transformaciones no destruyen información necesaria.
Esto afecta a productos y variantes, clientes y direcciones, pedidos y líneas, precios y tarifas, imágenes y atributos.
También afecta a la trazabilidad.
Cuando encontramos un error en el ecommerce, necesitamos poder determinar qué dato de origen lo produjo, qué transformación se aplicó y qué operación modificó el destino.
Y, cuando sea necesario, debemos disponer de mecanismos de corrección, compensación o reversión.
La integridad no se limita a comprobar claves foráneas o relaciones entre tablas.
Significa que el conjunto de datos sigue representando correctamente la realidad del negocio después de atravesar la integración.
Hay una sexta cuestión que no podemos ignorar: el tiempo
Hasta aquí hemos hablado de la calidad de cada dato y de las relaciones que mantiene con los demás.
Pero cuando integramos sistemas vivos aparece una dificultad adicional.
Los datos cambian mientras trabajamos con ellos.
Imaginemos esta secuencia:
- El ERP informa de 20 unidades disponibles.
- La integración consulta ese valor.
- Un comercial registra una venta de 8 unidades en el ERP.
- El ecommerce recibe la actualización anterior y publica 20 unidades.
- Antes de la siguiente sincronización, un cliente realiza una compra que supera la disponibilidad real.
Todos los datos utilizados en la integración podían ser correctos en el momento en que fueron consultados.
El problema es que dejaron de representar el estado actual.
Esta es la dimensión temporal de la calidad del dato.
En un almacén de datos, la actualidad suele medirse en función del retraso con el que se incorpora la información.
En una integración operativa también debemos considerar el orden de los cambios, la concurrencia, los reintentos y los conflictos entre actualizaciones.
No todas las entidades necesitan sincronizarse con la misma frecuencia.
La descripción de un producto puede tolerar cierto retraso. La disponibilidad de una referencia con pocas existencias quizá no.
Y una sincronización muy frecuente no garantiza por sí sola la consistencia: si dos sistemas pueden modificar simultáneamente el mismo dato sin una política de resolución, aumentamos la velocidad del conflicto.
Esto nos lleva a una cuestión fundamental: ¿quién tiene autoridad sobre cada dato?
Si el ERP es responsable del stock, el ecommerce no debería convertirse accidentalmente en una segunda fuente de verdad. Si el ecommerce gestiona las promociones, actualizar precios desde el ERP no debería sobrescribirlas sin tener en cuenta esa responsabilidad.
Una buena integración necesita definir qué sistema gobierna cada información, cómo se propagan sus cambios y qué ocurre cuando aparecen conflictos.
La sincronización bidireccional no significa que todos los datos deban poder modificarse indistintamente desde ambos lados.
La calidad de un dato operativo también depende de cuándo es válido, quién puede modificarlo y durante cuánto tiempo podemos confiar en él.
La calidad del dato no es responsabilidad exclusiva del sistema de origen
Una respuesta habitual ante los problemas de integración consiste en exigir que los datos estén perfectamente depurados antes de comenzar.
Es una aspiración razonable, pero insuficiente.
En primer lugar, porque un dato correcto en origen puede no ser suficiente para el destino.
En segundo lugar, porque muchas inconsistencias solo aparecen cuando relacionamos información de sistemas diferentes.
Y, finalmente, porque los datos seguirán cambiando después de completar cualquier proyecto de limpieza.
La calidad no puede ser una actividad puntual anterior a la integración.
Debe formar parte del funcionamiento normal del proceso.
Eso no significa que la integración deba asumir todas las responsabilidades de calidad de datos de la empresa.
Si un producto tiene una descripción comercial incorrecta, probablemente deba corregirse en el sistema que la gestiona. Si dos clientes están duplicados en el ERP, quizá sea necesario resolver allí su identidad.
La integración debe identificar el problema, aplicar las reglas que le correspondan y evitar propagar información que no pueda procesarse con garantías.
Hay una diferencia importante entre corregir un dato en su sistema responsable y transformarlo para que sea válido en otro sistema.
Una herramienta de integración necesita comprender esa diferencia.
¿Dónde deben aplicarse los controles de calidad?
Podemos pensar en una integración como una secuencia de operaciones que transforma información procedente de una o varias fuentes hasta convertirla en datos que otro sistema puede utilizar.
En ese recorrido existen diferentes oportunidades de control.
Al consultar el origen, podemos comprobar que recibimos los registros esperados, identificar campos ausentes y verificar las condiciones necesarias para continuar.
Al relacionar fuentes, podemos comprobar correspondencias, resolver identificadores y detectar inconsistencias entre entidades.
Durante la transformación, podemos validar tipos, unidades, formatos y estructuras, además de comprobar que las relaciones se mantienen.
Antes de escribir en el destino, podemos evaluar las reglas de negocio, evitar duplicados y determinar si debemos crear, actualizar, omitir o rechazar una operación.
Después de la escritura, podemos verificar el resultado, registrar incidencias y conservar la trazabilidad necesaria para diagnosticar errores.
No todos los controles deben ejecutarse siempre ni con el mismo coste.
Una integración que actualiza miles de registros de stock cada pocos minutos necesita controles diferentes de otra que crea productos complejos una vez al día.
El objetivo no es convertir cada sincronización en una auditoría completa.
Es aplicar los controles adecuados en el momento en que pueden evitar un problema.
Y, sobre todo, evitar una situación bastante habitual: descubrir los errores de calidad cuando ya han llegado al sistema de destino y han empezado a afectar a sus operaciones.
Automatizar las comprobaciones no significa automatizar todas las decisiones
Aquí aparece otra distinción importante.
Podemos automatizar la detección de un precio negativo, de un SKU inexistente o de una correspondencia duplicada.
También podemos automatizar muchas correcciones cuando existen reglas explícitas.
Por ejemplo, convertir unidades de medida, normalizar formatos, seleccionar una tarifa o relacionar códigos equivalentes.
Pero hay decisiones que dependen del negocio.
Si dos sistemas tienen precios diferentes, ¿cuál prevalece?
Si un producto no tiene imágenes, ¿debe publicarse igualmente?
Si un cliente existe en el ecommerce, pero no en el ERP, ¿debemos crearlo automáticamente?
Si no hay existencias propias, ¿podemos utilizar la disponibilidad del proveedor?
Estas preguntas no tienen una respuesta universal.
Dependen de cómo trabaja cada empresa.
Y aquí es donde la automatización debe combinar dos capacidades diferentes: comprender las particularidades del negocio y ejecutar sus reglas de manera previsible.
El razonamiento puede ayudar a descubrir estructuras, identificar patrones y proponer correspondencias o configuraciones.
La ejecución operativa, en cambio, debe apoyarse en decisiones explícitas, comprobables y trazables.
No necesitamos que un sistema improvise qué hacer con un pedido cada vez que encuentra una anomalía.
Necesitamos que aplique la política que hemos definido y que nos informe cuando aparece una situación no contemplada.
Cómo encaja Distillsync en este enfoque
En Distillsync partimos de una idea: integrar aplicaciones no debería obligarnos a tratar cada combinación de tecnologías como un problema completamente nuevo.
Aunque un ERP y un ecommerce tengan modelos de datos diferentes, comparten conceptos de negocio reconocibles: productos, variantes, precios, stock, clientes y pedidos.
Nuestro Metamodelo semántico permite trabajar con estos conceptos de forma común, sin exigir que los sistemas originales utilicen las mismas estructuras.
Sobre esa representación, las tareas de integración organizan las fuentes, las consultas, las transformaciones y las decisiones necesarias para llevar los datos de un sistema a otro.
Esto permite abordar la calidad desde varias perspectivas.
Primero, comprender qué representa la información que encontramos en cada aplicación y cómo se corresponde con los conceptos del negocio.
Después, determinar qué datos necesitamos realmente para cada operación y de dónde deben obtenerse.
Y finalmente, aplicar las transformaciones, validaciones y decisiones configuradas para que la información llegue al destino de manera coherente.
El asistente de descubrimiento ayuda a identificar las particularidades de los sistemas y a proponer configuraciones a partir de su estructura y sus datos. Pero las reglas de negocio no deberían depender de interpretaciones improvisadas durante cada ejecución.
El razonamiento ayuda a comprender cómo funciona cada empresa. Las decisiones configuradas determinan cómo debe funcionar su integración.
Esta separación es importante para la calidad del dato.
Distillsync no parte de una página en blanco en la que debamos programar cada integración desde cero. Proporciona una estructura de trabajo basada en conceptos de negocio, tareas y decisiones que podemos adaptar a las particularidades de cada empresa.
Por ejemplo, podemos configurar qué información debe estar presente antes de publicar un producto, cómo relacionar las referencias entre el ERP y el ecommerce, qué condiciones debe cumplir un precio o qué hacer cuando no encontramos una correspondencia válida.
También podemos combinar información procedente de distintas fuentes sin asumir que una sola aplicación contiene todos los datos necesarios. El ERP puede proporcionar las referencias y existencias, mientras que otra fuente aporta imágenes, atributos o información comercial.
La cuestión no es imponer un modelo de datos idéntico a todos los sistemas. Es disponer de una representación común que permita comprender sus diferencias y trabajar con ellas.
Y tampoco se trata de que Distillsync decida por la empresa qué datos son correctos. La empresa establece sus reglas; Distillsync proporciona las herramientas para representarlas, aplicarlas y automatizar su ejecución.
De esta forma, la integración deja de ser una sucesión de correspondencias técnicas entre campos y pasa a representar procesos de negocio que pueden configurarse, supervisarse y evolucionar.
Porque una integración que funciona hoy también debe poder adaptarse cuando mañana cambie una tarifa, aparezca una nueva familia de productos o la empresa decida gestionar sus existencias de otra manera.
La calidad del dato no es un control más. Es lo que permite que todo encaje.
Volvamos a nuestras zapatillas deportivas.
Tenemos un ERP que conoce sus referencias y existencias. Un ecommerce que necesita variantes, precios e imágenes. Un proveedor que aporta información adicional. Y una empresa que sabe cómo quiere vender sus productos.
Podemos conectar todas estas aplicaciones, programar sincronizaciones frecuentes y conseguir que intercambien miles de registros sin errores técnicos.
Pero eso no garantiza que el resultado sea correcto.
Si confundimos un producto con una variante, una existencia física con una disponibilidad comercial o una tarifa general con el precio que corresponde a un cliente, estaremos automatizando un problema.
La calidad del dato en una integración operativa consiste precisamente en evitarlo.
Necesitamos información suficiente para cada operación, comprender su significado, validar las reglas que debe cumplir, identificar correctamente las entidades y preservar sus relaciones. Y debemos hacerlo teniendo en cuenta que los sistemas siguen funcionando y los datos continúan cambiando.
No todas las diferencias entre aplicaciones son errores que debamos corregir. Muchas representan decisiones legítimas de negocio.
Una buena integración no elimina esas diferencias. Las comprende y las respeta.
Por eso, la calidad del dato no debería aparecer al final del proyecto como una última comprobación antes de ponerlo en producción. Debe estar presente desde el momento en que definimos qué queremos sincronizar, cómo interpretamos la información y qué debe ocurrir en cada situación.
Al fin y al cabo, el objetivo no es conseguir que dos aplicaciones tengan exactamente los mismos datos.
Es conseguir que cada una disponga de la información que necesita, con el significado adecuado y en el momento oportuno, para que la empresa pueda seguir trabajando.
Los datos de calidad permiten que una integración funcione. Una integración bien diseñada ayuda a conservar esa calidad mientras el negocio evoluciona.
¿Tu ERP y tu ecommerce representan los mismos datos de manera diferente?
Con Distillsync puedes conectar tus aplicaciones mediante un metamodelo semántico común, descubrir cómo están organizados sus datos y configurar las transformaciones y decisiones que necesita tu negocio.
Sin desarrollar una integración diferente desde cero para cada caso. Sin renunciar a tus propias reglas.
Integra tus sistemas. Mantén el control de tus datos.